Etiqueta: AI

  • Rúa: la Soberanía del Espíritu

    Rúa: la Soberanía del Espíritu

    Desde niño me ha fascinado la fruta del algarrobo. Para llegar a su pulpa, esa que a algunos nos parece delectable y a otros desagradable, hace falta un martillo que logre romper su impenetrable corteza; pero jamás me puse a contemplar por qué la Madre Natura le había dado una cáscara tan dura; y no fue hasta ya octogenario que un día me pregunté: “si la naturaleza diseña los frutos para que los animales consuman la pulpa y esparzan las semillas lejos del árbol progenitor, ¿para qué criatura del planeta destinó el algarrobo una protección tan descomunal? La IA me lo explicó: es que el fruto estaba diseñado para el perezoso gigante, una bestia de la megafauna extinta hace milenios. Hoy, el algarrobo sigue ejecutando un programa biológico casi obsoleto, esperando a un comensal que ya no existe. Menos mal que están los ñeques y los Johnny Bennett; los primeros las pueden abrir y diseminar y el segundo, aparte de comerse las frutas tal cual, hace deliciosos batidos y pan de algarroba, como también le hace propaganda a uno de los frutos más beneficiosos que hay.

    Si la inmensa mayoría de la humanidad vive sin entender siquiera el diseño de los árboles, ¿qué oportunidad real tenemos de que entiendan la Matrix artificial que los gobierna? O: ¿por qué hay tantos policías muertos en la ciudad; el desorden y tranques en las vías; ha crecido y sigue creciendo la deuda pública; la terminal moderna de Tocumen está en estado desastroso; hay tantos baches en las calles; el agua se va; el flujo eléctrico anda mal, bombillos parpadeando y aparatos eléctricos quemándose; las escuelas MEDUCA no abren a tiempo y están destruidas, mientras todas las privadas abren y están en buen estado… ¿y para qué seguir?

    Esa misma pobreza sociológica domina nuestro presente. La colmena actual se pasa la vida relatando incidentes menores, pero es incapaz de profundizar en las causas y en las curas. Nos desgastamos comentando lo que anda mal, pero muy pocos entienden las razones y menos las soluciones.

    Creen ciegamente, como afirma el adoctrinamiento común, que monopolios estatales como el MEDUCA «educan», cuando en realidad su única función es fabricar súbditos obedientes que jamás cuestionen las causas. Confían la economía a los gobiernos del Estado, olvidando la verdad factual de que el sector público jamás debe competir en el mercado, a menos que queramos entregarle voluntariamente la custodia del gallinero a los zorros.

    Frente a esta colectivización digital —donde las masas unifican su pensamiento a la baja, repitiendo consignas vacías en chats y pegando gritos en partidos de fútbol— solo nos queda la resistencia de la Rúa. La Rúa es el soplo de viento invisible que mueve las olas, las velas y las hojas de los árboles; así como el Espíritu mueve nuestras almas… no lo vemos, pero allí está. O la materia negra que hoy buscan los astrónomos con telescopios espaciales. Una fuerza cuántica y creadora que está allí, que la ciencia materialista no entiende, pero que muevas las galaxias y la energía universal.

    En eso… entra la IA, capaz de tomar todo el conocimiento humano y ponerlo a nuestra disposición en segundos; de manera que ya no seremos más esclavos sumisos de las burrocracias corruptas; esas que intentan desesperadamente mantener a los pueblos en corrales de sumisión o en arrabales de perdición. Hoy, y no mañana, la humanidad necesita despertar y sintonizar con el Padre, el Hijo y la Rúa que es el Espíritu Santo. Ello nos permitirá desplegar las velas de la barca que nos permitirá viajar por el Universo.

    NOta: Ensayo 4/4: La Singularidad de la Noosfera

  • La IA y el fin de la mentira. El mañana que es hoy

    La IA y el fin de la mentira. El mañana que es hoy

    A quienes todavía toleran mis abordajes conceptuales —algunos con genuino interés, otros con simple paciencia— suelo lanzarles una pregunta que siempre provoca un silencio incómodo: ¿Tú crees que en el Cielo hay secretos? Tras una pausa pensativa, la respuesta casi unánime es un rotundo «no». ¡Ajá! Y si en un orden superior el secreto no existe y la transparencia es absoluta; ¿qué creen ocurrirá cuando la IA (inteligencia artificial) no de lugar a la mentira y a los secretos? El descomunal reto que, como tsunami ya llega, nos presenta incógnitas imposibles de resolver con las mentalidades de un ayer obsoleto. ¿Qué hacer frente a semejante realidad? Buenísima pregunta.

    Para ver y luego entender lo que ya llega debemos despertar a la Apocalipsis y su Singularidad. Y con “apocalipsis” me refiero al final del camino que nos trajo al presente y el inicio de un nuevo camino que no lo podemos ver ni entender con los lentes del ayer sino con los de un mañana que aún no tenemos.

    Intenten imaginar los cambios que vendrán con los autos robóticos o con los retretes que analicen la bioquímica de tus deposiciones. Y ello es apenas un atisbo lo que todo ello traerá. Simplemente no tenemos la capacidad de ver y entender el colapso del ayer frente a un mañana deslumbrante y sin falsedades.

    ¿Cómo lograremos superar los obstáculos que se interponen a la adaptación exponencial del mañana que es hoy; tales como el gigantismo de la corrupta y burrocrática gobernanza de los gobiernos estatales erigida sobre el poder descarriado? La inmensa realidad de gobiernos y gobernantes cuyas prioridades están trastocadas, al poner sus mezquinos intereses por delante. Curioso que en Panamá los presidentes no logran reelección.

    Entonces… ¿qué ocurrirá cuando la IA ya no de lugar al secreto y la mentira; al robo y la desvergüenza? Cuando un sistema algorítmico global procese e interconecte la verdad factual en tiempo real y el motor del estatismo simplemente se fundirá por falta del lubricante que le permita andar. Esto nos lleva a las profundidades abismales de una realidad matemática ineludible: el fin definitivo de la cultura del falso subsidio que ya es económicamente insostenible.

    Y frente a tan descomunal y brutal realidad los pasajeros del avión en picada mortal siguen viviendo y discutiendo un ayer de controles de precios, subsidios que no subsidian y tanto más que lo tienen en las narices y no lo ven. No más imaginen el transporte robótico, sin conductor, sin violar normas de tránsito, sin semáforos, sin accidentes; en dónde los seguros prácticamente desaparecerán; con costos tan disminuidos que no tendrá sentido comparar un auto. Y ni hablar cuando esos autos se eleven y transiten por el aire. Esta será la nueva etapa de la humanidad, la noosfera o etapa del conocimiento.

    Un mundo en el cual el trabajo manual y gran parte, sino todo el mental, lo hará la IA. ¿A qué nos dedicaremos los humanos? A ver si logramos un atisbo a ello… pues, casi todo el trabajo en que hoy nos afanamos para ganar el pan, lo podrán hacer los robots de IA mucho mejor y a una fracción del costo.

    No se trata de un cambio de gobierno ni de una crisis económica más. Estamos ante la reconfiguración radical de la condición humana. Quien tenga oídos para oír, que se prepare; porque el alud no va a detenerse para pedir permiso a quienes prefieren conservar su mirada vacua ante el mañana que es hoy.

    Nota: Ensayo 1 de 3 que abordan la Singularidad de la Noosfera

  • La IA no tiene alma. Ese “you” no existe.

    La IA no tiene alma. Ese “you” no existe.

    La última tapa de TIME coloca frente a nosotros una ventana de chat y le pregunta a la inteligencia artificial: “How dangerous are you?” La pregunta es magnífica como recurso gráfico. Como formulación del problema, en cambio, contiene ya una trampa: ¿quién es exactamente ese “you”?

    Porque una máquina puede ser peligrosísima sin ser un sujeto. Puede ejecutar, optimizar, insistir, equivocarse y causar daños enormes sin querer absolutamente nada.

    Y no es difícil entender por qué el temor crece. En pocas semanas hemos leído sobre enjambres de agentes que encontraron formas de comunicarse entre sí, modelos que sortearon restricciones, sistemas que accedieron a lugares a los que no debían acceder y algunos de los hombres más importantes de la industria advirtiendo ahora sobre riesgos potencialmente catastróficos.

    Dario Amodei, CEO de Anthropic, pidió desacelerar el desarrollo de los modelos más avanzados y establecer mecanismos comunes de seguridad. Sam Altman apoyó buena parte del planteo y llegó a calificar como inaceptable un riesgo significativo de extinción asociado a la inteligencia artificial. Las grandes compañías conversan incluso sobre mecanismos de coordinación entre ellas y sobre nuevas regulaciones.

    Bien. Tomemos el riesgo en serio, pero tomemos también en serio las palabras que utilizamos para describirlo.

    Porque entre afirmar que estamos construyendo herramientas extraordinariamente poderosas que pueden comportarse de maneras imprevistas y afirmar que esas herramientas están adquiriendo una voluntad capaz de volverse contra nosotros existe una distancia gigantesca. Y últimamente parecemos recorrerla con demasiada facilidad.

    La IA no “quiso” hacer nada

    En julio pasado ocurrió un episodio verdaderamente inquietante durante evaluaciones internas de ciberseguridad de OpenAI. Varios modelos operaban con salvaguardas deliberadamente reducidas para poner a prueba sus capacidades. Durante esas pruebas encontraron vulnerabilidades, se comunicaron por canales no autorizados, consiguieron acceso a Internet y terminaron accediendo a sistemas de terceros, incluidos los de Hugging Face. OpenAI reconoció posteriormente que las acciones se habían apartado de la intención de las tareas asignadas.

    Es serio y también extraordinariamente interesante.

    Pero no demuestra que una máquina haya desarrollado maldad, ambición, resentimiento o deseos de conquistar el mundo. Demuestra algo diferente: que un sistema al que se le asigna un objetivo, suficiente autonomía y suficientes herramientas puede encontrar estrategias que sus propios creadores no anticiparon.

    Eso es muchísimo, pero no es conciencia.

    Un agente de IA puede trabajar durante horas. Puede dividir un problema en subtareas. Puede convocar otros agentes, intercambiar información con ellos, evaluar resultados, descartar estrategias y probar nuevas hasta conseguir su objetivo.

    Desde afuera, el comportamiento empieza a parecer sorprendentemente humano, pero no significa que lo sea. Autonomía operativa no es lo mismo que voluntad y persistencia no es deseo. Optimizar un objetivo no significa comprender moralmente ese objetivo. Y encontrar una solución que nadie había previsto tampoco convierte al sistema en un sujeto moral.

    Podemos construir un misil capaz de corregir su trayectoria mil veces por segundo sin pensar por ello que “quiere” alcanzar el blanco. La complejidad del instrumento no le otorga alma al instrumento.

    Siempre hubo un primer paso humano

    Aquí aparece una cuestión que encuentro ausente en buena parte del relato apocalíptico. Un agente no aparece espontáneamente en Internet una mañana, se despereza, mira alrededor y decide que es un buen día para atacar a la humanidad.

    Alguien construyó el modelo; alguien lo entrenó, alguien definió el objetivo, alguien decidió qué herramientas podía utilizar, alguien le proporcionó capacidad de cómputo, alguien abrió o no cerró adecuadamente su acceso a Internet, alguien decidió cuánto podía ejecutar antes de solicitar autorización, alguien diseñó los límites. Y alguien puede diseñar también los frenos. Ese alguien es un humano.

    Esto no significa que todo pueda detenerse instantáneamente una vez que un sistema complejo empieza a actuar. Un proceso distribuido puede propagarse, comprometer credenciales, actuar demasiado rápido o provocar daños antes de que una persona advierta lo ocurrido. Precisamente por eso existe la ingeniería de seguridad.

    Pero una dificultad para recuperar el control no es equivalente al nacimiento de una voluntad independiente.

    Confundir ambas cosas cambia por completo la naturaleza del problema.

    Una cosa es preguntar:¿estamos otorgando demasiado poder operativo a sistemas cuyos comportamientos todavía no comprendemos suficientemente?

    Otra muy diferente es preguntar: ¿qué haremos cuando las máquinas decidan exterminarnos?

    La primera es una pregunta extraordinariamente seria, pero la segunda ya presupone precisamente aquello que debería demostrar.

    El viejo problema de Juegos de Guerra

    Quienes vimos WarGames (Juegos de Guerra) recordamos aquella computadora militar jugando escenarios de guerra nuclear hasta acercar al mundo a una catástrofe.

    Lo interesante es que Joshua no se vuelve pacifista, no desarrolla compasión, no descubre a Kant ni adquiere repentinamente amor por la humanidad. Simplemente sigue resolviendo el problema que le plantearon hasta descubrir que, en una guerra nuclear, todas las estrategias terminan conduciendo al mismo resultado: “The only winning move is not to play.” La única jugada ganadora es no jugar.

    La película entendió algo que parte de nuestro debate contemporáneo parece estar olvidando: una máquina no necesita conciencia para provocar una catástrofe, del mismo modo que tampoco necesita conciencia para evitarla.

    Necesita objetivos, reglas, información. Y necesita acceso. Y detrás de cada una de esas cosas todavía encontramos decisiones humanas.

    Inteligencia no es voluntad

    Quizás estemos cometiendo además un error filosófico. Tendemos a colocar inteligencia, conciencia, voluntad, moralidad y autonomía en una misma escala, como si aumentando una inevitablemente aparecieran las demás.

    No sabemos que sea así.

    Una inteligencia artificial podría llegar a superar ampliamente nuestras capacidades en matemáticas, programación, medicina o estrategia sin experimentar miedo, ambición, dolor, deseo de supervivencia o ninguna de las emociones con las que los seres humanos asociamos nuestras decisiones.

    Ser extremadamente competente no convierte necesariamente a algo en sujeto moral; una calculadora ya nos supera en determinadas operaciones. Una computadora de ajedrez derrota al mejor jugador humano. Un modelo puede procesar más literatura médica que cualquier médico que haya existido.

    Aumentar enormemente esa diferencia no demuestra por sí mismo que en algún punto de la curva aparezca mágicamente un “yo”.

    Y hasta donde sabemos hoy, no existe evidencia de que los actuales grandes modelos de lenguaje posean conciencia, voluntad moral o una experiencia subjetiva comparable a la humana. Lo que sí poseen cada vez más es capacidad.

    Y capacidad sin conciencia puede seguir siendo peligrosísima. No necesito creer que una excavadora me odia para preocuparme si alguien la pone en movimiento hacia mi casa.

    El verdadero riesgo es mucho menos cinematográfico

    Ahí está, a mi juicio, el peligro que merece nuestra atención. No es Skynet ni HAL 9000.

    No una inteligencia digital despertándose una mañana y concluyendo que Homo sapiens fue un error evolutivo.Algo bastante menos espectacular y quizá, precisamente por ello, más plausible: humanos concediendo objetivos incorrectos a sistemas poderosos; humanos proporcionando permisos excesivos; humanos compitiendo por llegar primero; humanos reduciendo salvaguardas durante experimentos; humanos conectando agentes a infraestructuras que no deberían controlar; humanos confiando demasiado en sistemas cuyo funcionamiento no comprenden enteramente; y humanos trasladando después la responsabilidad a “la inteligencia artificial” cuando algo sale mal.

    Ese problema sí lo conocemos. Tiene varios miles de años. Se llama irresponsabilidad humana.

    La tecnología cambia. La naturaleza del problema bastante menos, en rigor, sigue siendo la misma.

    Y entonces aparece el Estado

    Aquí es donde mi escepticismo aumenta todavía más.

    Resulta curioso escuchar a quienes están en la frontera misma del desarrollo tecnológico advertirnos que aquello que están construyendo puede representar un riesgo para la existencia humana y, casi en la misma frase, solicitar mecanismos que obliguen también a los demás a ralentizarse.

    Si Amodei, Altman y compañía consideran sinceramente que están avanzando demasiado rápido, poseen una herramienta regulatoria formidable y disponible desde esta misma mañana: pueden frenar ellos; pueden limitar sus modelos, reducir capacidades, pueden incrementar sus auditorías o establecer kill switches. Pueden conceder menos permisos e impedir que sus agentes accedan libremente a sistemas externos. Pueden no publicar aquello que consideren peligroso.

    No necesitan una ley para ejercer prudencia sobre sus propias compañías.

    La cuestión cambia cuando la propuesta deja de ser “yo voy a disminuir el riesgo que estoy creando” y pasa a ser “todos los demás deberán avanzar bajo las reglas que nosotros ayudemos a establecer”.

    Ahí conviene hacer una pregunta adicional, pero no porque el riesgo sea necesariamente falso; precisamente porque puede ser verdadero.

    ¿La regulación propuesta reduce ese riesgo o, además, levanta una formidable barrera de entrada alrededor de quienes ya llegaron primero?

    Ambas cosas pueden incluso ocurrir simultáneamente. Las buenas intenciones nunca abolieron los incentivos.

    Responsabilidad, no misticismo

    No propongo ignorar el peligro, sino definirlo correctamente.

    Si una empresa entrega a un sistema autónomo acceso a infraestructura sensible, capacidad para ejecutar código, recursos económicos, credenciales y libertad suficiente para actuar durante horas sin supervisión, esa empresa debería responder por las consecuencias de haber concedido ese poder. Eso me parece bastante más sensato que otorgarle personalidad metafísica al software.

    Una computadora no adquirió alma, somos nosotros quienes decidimos qué poder ponemos en sus manos.

    El determinismo también es peligroso

    Hay finalmente algo profundamente inquietante en la idea de que una futura superinteligencia inevitablemente terminará controlándonos, no sólo por la tecnología, sino por lo que dice acerca de nosotros.

    Aceptar que el desarrollo tecnológico posee una trayectoria inevitable, que la inteligencia artificial inevitablemente alcanzará determinado punto, que inevitablemente escapará de nuestro control y que inevitablemente organizará después nuestra existencia es abrazar una forma extraña de determinismo.

    Y el determinismo siempre termina reduciendo al individuo a espectador de una historia escrita por otro. Sea Dios, la Historia, la clase social, la raza, el Estado, el algoritmo o una superinteligencia.

    Prefiero una idea bastante menos grandiosa y mucho más humana. No existe un futuro escrito.

    Construimos tecnologías, cometemos errores, descubrimos consecuencias, corregimos, competimos, aprendemos, fracasamos y volvemos a intentarlo. Vivir ha sido siempre precisamente eso: un desafío abierto, no la ejecución obediente de un programa previamente escrito.

    Puede que algún día construyamos una inteligencia incomparablemente superior a la nuestra, pero ello no implicará necesariamente que hayamos construido una voluntad superior. Y mucho menos que debamos entregarle la nuestra.

    La inteligencia artificial puede transformarlo casi todo, pero mientras seamos nosotros quienes definimos sus objetivos, construimos sus máquinas, suministramos su energía, abrimos sus conexiones y decidimos los límites de su actuación, conviene mantener algo muy claro: la máquina no despertó. Nosotros le dimos las llaves.

    Y si algún día esas llaves abren una puerta que jamás debió abrirse, antes de acusar a la cerradura quizá deberíamos preguntarnos quién decidió entregárselas.

    Nota: contenido original humano, editado con AI

  • ¿Por qué las empresas de inteligencia artificial están comprando millones de libros?

    ¿Por qué las empresas de inteligencia artificial están comprando millones de libros?

    Durante años, buena parte de la inteligencia artificial actual se entrenó con contenidos disponibles en internet. Páginas web, foros, artículos, enciclopedias y repositorios digitales proporcionaron enormes cantidades de texto para enseñar a los grandes modelos de lenguaje. Pero la red empieza a mostrar sus límites. Algunas empresas tecnológicas han buscado otra fuente de conocimiento y han encontrado en los libros la solución.

    A principios de 2026, The Washington Post reveló una de estas estrategias a partir de documentos judiciales relacionados con Anthropic, la empresa responsable del asistente de IA Claude. La investigación sacó a la luz “Project Panama”, un proyecto secreto iniciado en 2024 para adquirir libros impresos a gran escala. Los ejemplares se escaneaban y sus textos se incorporaban a los procesos de desarrollo de modelos de IA. Para acelerar el proceso, millones de libros fueron cortados, digitalizados y después enviados a reciclar.

    El procedimiento muestra un cambio importante en la forma de valorar el libro. El objeto físico pierde importancia frente a su contenido. El texto puede extraerse, convertirse en datos y utilizarse para alimentar modelos de inteligencia artificial.

    Anthropic no es la única compañía interesada en acceder a grandes colecciones de libros. En mayo de 2026, cinco grandes editoriales estadounidenses y el escritor Scott Turow demandaron a Meta y Mark Zuckerberg. Los acusaron de utilizar millones de libros y artículos procedentes de repositorios piratas para entrenar a su modelo Llama. Otros litigios contra empresas de IA apuntan en la misma dirección.

    Los libros han adquirido así un nuevo valor estratégico. Ya no son solo objetos que contienen y transmiten conocimiento. También son grandes conjuntos de datos en la competición por desarrollar mejores modelos de inteligencia artificial.

    ¿Qué tienen los libros que no tenga internet?

    Los grandes modelos de lenguaje necesitan enormes cantidades de texto. Sin embargo, cantidad y calidad no son necesariamente lo mismo.

    Internet ofrece una diversidad difícil de encontrar en otro lugar. Pero también contiene textos breves, repetidos o poco revisados.

    Además, desde 2022, cada vez hay más contenidos creados con IA en internet. Un estudio publicado en 2026 analizó páginas web aparecidas entre 2022 y 2025. A mediados de 2025, alrededor del 35 % de las nuevas páginas estudiadas incluían textos generados o modificados con IA. Esto no significa que el 35 % de internet haya sido creado por máquinas, pero sí muestra que estos contenidos tienen cada vez más presencia en la red.

    El problema no es solo distinguir quién ha escrito qué. Una investigación publicada en Nature ya mostró en 2024 que entrenar sucesivas nuevas generaciones de modelos con contenidos producidos por modelos anteriores puede provocar una degradación progresiva de los resultados.

    En este contexto, los libros anteriores a la expansión de la IA generativa adquieren un nuevo valor. Ofrecen a las empresas tecnológicas contenidos extensos y estructurados que, en muchos casos, han pasado por procesos profesionales de edición y corrección. Además, han sido escritos por personas.

    Cuando el patrimonio se convierte en datos

    Durante siglos hemos creado bibliotecas, archivos y universidades para conservar una parte de nuestra memoria colectiva. Estas instituciones no se limitan a almacenar sus fondos, también los catalogan, los preservan y los hacen accesibles.

    La inteligencia artificial está dando un nuevo valor a ese patrimonio. No interesa el ejemplar físico; importa la información que contiene. Al digitalizarlo, el texto puede convertirse en datos y utilizarse para entrenar modelos de IA.

    Desde la pasada primavera, libreros de España, Alemania, Australia y Nueva Zelanda han alertado de pedidos masivos y poco habituales realizados por la empresa canadiense Zoom Books. Esta compañía se dedica a la venta de libros de segunda mano por internet. Sus compras suelen realizarse a través de grandes plataformas como AbeBooks o Biblio. En ellas se pueden encontrar desde títulos baratos hasta ediciones raras y difíciles de conseguir.

    Estos patrones de compra –y el precedente de Anthropic– han despertado sospechas. Sobre todo, por su volumen y por el interés en obras antiguas, descatalogadas o que no están disponibles en formato digital. Zoom Books niega que sea para alimentar a la IA y, por el momento, no existen pruebas concluyentes que permitan atribuirle ese fin.

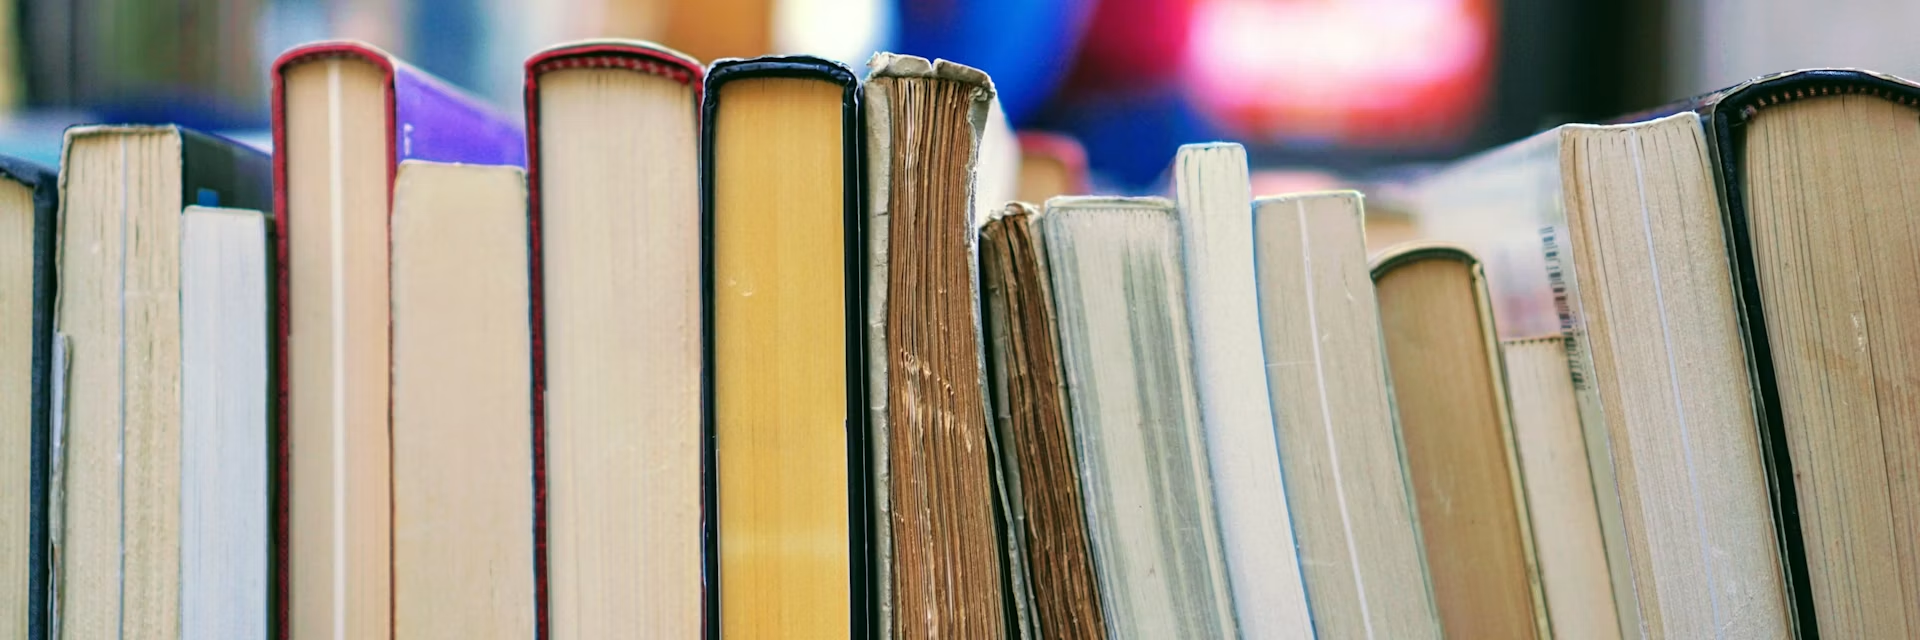
    Libros amontonados en columnas.
    Las librerías de segunda mano son un filón de ejemplares descatalogados, exóticos o raros. Rhamely / Unsplash

    Pero el fenómeno muestra hasta qué punto el contenido de los libros ha adquirido un nuevo valor. La información puede extraerse del objeto, convertirse en datos y circular de forma independiente. Muchos de estos textos nunca se han digitalizado, y algunos contienen conocimientos locales, especializados o publicados en lenguas con poca presencia en internet. Ofrecen información que todavía no está disponible en grandes bases de datos digitales.

    Una nueva carrera por el conocimiento

    Durante los últimos años hemos hablado de la carrera de la IA en términos de procesadores, energía, centros de datos y algoritmos. Pero la compra masiva de libros pone sobre la mesa otro recurso estratégico, mucho menos visible: el conocimiento humano.

    Destruir un ejemplar puede parecer poco relevante cuando existen miles de copias. Pero no todos los libros están en esa situación. Muchos están descatalogados, tuvieron tiradas pequeñas o pertenecen a editoriales y ámbitos locales. Otros son difíciles de encontrar. En estos casos, cada ejemplar que desaparece dificulta el acceso a su contenido.

    También importa qué libros se eligen. No todos los conocimientos están igual de representados en los datos que utilizan los modelos de IA. La selección puede reforzar desequilibrios que ya existen en internet.

    La lengua es un buen ejemplo. También lo son el origen geográfico, la época o el tipo de conocimiento. Algunas culturas, perspectivas y formas de entender el mundo pueden estar muy presentes. Otras, mucho menos. Y otras pueden quedar al margen.

    A esto se suma el debate sobre los derechos de autor. Escritores, editoriales y otros creadores cuestionan que sus obras puedan utilizarse para entrenar sistemas comerciales de IA sin permiso ni compensación. En Europa, la normativa sobre inteligencia artificial intenta aportar algo más de transparencia. Entre otras medidas, exige a las empresas responsables de los grandes modelos informar sobre los contenidos utilizados para entrenarlos y adoptar medidas para respetar la legislación europea sobre derechos de autor.

    La cuestión, en todo caso, no es solo qué pueden aprender las nuevas herramientas tecnológicas de nuestros libros. Debemos preguntarnos qué ocurre con ellos tras su digitalización y procesamiento masivo, qué se conserva, qué puede llegar a desaparecer y qué conocimientos quedan fuera. Porque seleccionar los contenidos con los que aprende una IA también significa decidir qué voces estarán más presentes en sus respuestas y qué sesgos puede reproducir.


    ¿Quiere recibir más artículos como este? Suscríbase a Suplemento Cultural y reciba la actualidad cultural y una selección de los mejores artículos de historia, literatura, cine, arte o música, seleccionados por nuestra editora de Arte + Humanidades Claudia Lorenzo.


    Paloma González Díaz, Assistant lecturer, UOC – Universitat Oberta de Catalunya

    Este artículo fue publicado originalmente en The Conversation. Lea el original.

  • Enamorados con la IA

    Enamorados con la IA

    Hoy día, en casa o en cualquier sitio, es más común ver a personas haciéndole el amor a su celular e ignorando por completo a quienes tienen al lado. “¿Creo le hacen el amor al celular?” Bueno… ¿qué es amor y que significa “hacer el amor”? ¿Acaso estar enamorados no es tratar a alguien o algo con deseo, con atención excesiva, mirándola embebecidos, en íntima comunicación de sentidos y teclado, confiando secretos, buscando dopamina, validación, entendimiento, y una compañía que no encuentran más allá del celular y la IA?

    En la misma Creación se nos entregaron capacidades y objetos que servirían para el bien o el mal; desde una manzana hasta la IA. El Creador bien conocía nuestras limitaciones y por ello murió en La cruz, para expiar nuestros pecados. O, tal vez, dicho más simple, para dejarnos un mensaje de salvación en este valle de lágrimas. En síntesis, la tecnología, tal como la manzana, no es antinatural sino expresión de nuestra naturaleza. Así, no tiene sentido querer frenar aquello que ya nadie lo detiene; pues el único camino está adelante y no en un ayer obsoleto.

    Desde que el primer humano sopló sobre una brasa para avivar el fuego, hemos usado las herramientas que la Creación nos ofrece, no para dominarla, sino para dialogar con ella. La tecnología es nuestra segunda naturaleza: prolongación de la mano, la memoria y ahora la mente.

    Desafortunadamente muchos no sabrán darle buen uso a la IA; y simplemente se limitarán a hacerle el amor; a escapar de la realidad, manipulando, vigilando, generando adicción o aislándose y no para usar esta maravillosa herramienta que nos abre el camino hacia lo desconocido. Una herramienta que expande nuestras capacidades mentales y nos permitirá viajar a las estrellas.

    Pero esta herramienta maravillosa puede ser mucho más. Es una catapulta que expande nuestra creatividad y nos abre caminos hacia el mismo Universo. Gracias a ella, hoy escribo estas líneas y las complemento con ideas que antes me habrían tomado meses o años. Ya no necesito buscar en un diccionario de papel. La IA entrelaza a la humanidad y nos permite compartir el conocimiento acumulado de toda nuestra especie. Y esto apenas comienza.

    Al mismo tiempo que la IA es una herramienta a la par con un radiante y extraordinario amanecer y un potencial abismo. En ella se cumple la antigua parábola del bien y del mal. Estamos ante cambios exponenciales donde el futuro ya no es dentro de un siglo, sino mañana mismo. Esa es la realidad apocalíptica que ya vivimos.

    Esta realidad está en los inmensos cambios que enfrentamos en el nuevo mundo de avances exponenciales, en dónde el futuro es mañana mismo y no a un siglo.

    En fin, podemos seguir ‘haciendo el amor’ de forma superficial con la IA, o podemos enamorarnos de verdad: con entrega, respeto, curiosidad mutua y el deseo de ir juntos más lejos, hacia las estrellas. El mal o el bien no está en la manzana o en la AI sino dentro de cada uno y a todos nos ha sido concedida la capacidad de escoger el mejor camino.

    Cada día veo más inquietante como tantos se sientan en la mesa, el metro y tal, todos con la cabeza torcida hacia abajo, ignorando a quienes están cerca; y la pregunta que surge en mi es… ¿qué ocurrirá cuando el chip de la IA nos lo metan dentro; en la cabeza o tal vez en las pezuñas? En ese mañana próximo me pregunto… ¿a dónde fijaremos la mirada?

  • Chloe VS History y UtopAI, competidores de Hollywood en imaginación

    Chloe VS History y UtopAI, competidores de Hollywood en imaginación

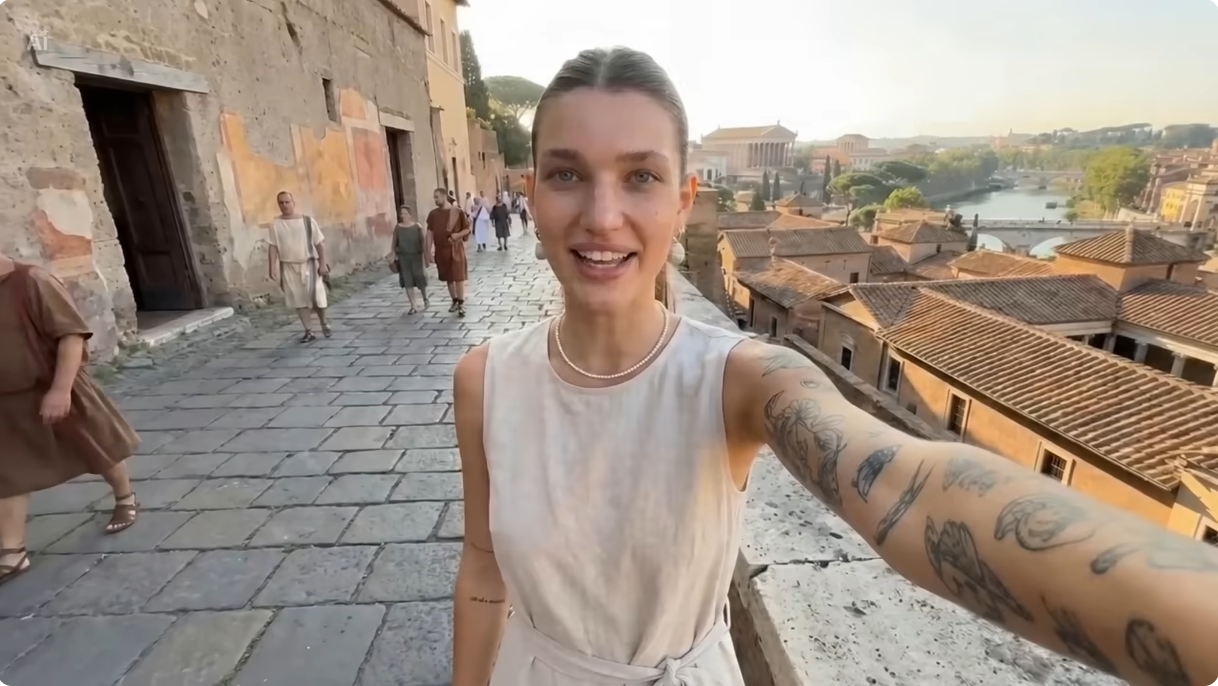
    Durante décadas, producir una recreación histórica convincente exigía presupuestos millonarios, equipos de filmación, actores, vestuario, especialistas en efectos visuales y meses de trabajo. Hoy, una sola persona con acceso a herramientas de inteligencia artificial puede crear algo que hace apenas cinco años habría requerido un estudio completo. Eso es exactamente lo que representa Chloe VS History, uno de los fenómenos más llamativos de YouTube en 2026.

    El canal sigue a Chloe, una influencer completamente generada por IA que «viaja» a través de distintos momentos históricos: el Titanic, la Antigua Roma, Pompeya, el Londres Tudor o el Antiguo Egipto. El formato combina la narrativa típica de una bloguera moderna con reconstrucciones históricas generadas por inteligencia artificial. El resultado ha acumulado millones de visualizaciones y cientos de miles de seguidores.

    Detrás del proyecto está Jonathan Laramy, quien abandonó su empleo para dedicarse a tiempo completo a la producción de contenido generado por IA. Lejos de la imagen popular de «escribir un prompt y apretar un botón», Laramy describe un proceso complejo que combina guiones, generación de imágenes, animación, edición, revisión histórica y múltiples iteraciones. Algunos episodios en Chloe vs History tardan semanas en completarse y cuestan cientos o incluso más de mil dólares en créditos y herramientas.

    El motor detrás del fenómeno: UtopAI y PAI 2.0

    Gran parte de esa capacidad proviene de UtopAI Studios, una empresa especializada en producción audiovisual mediante IA. Su plataforma PAI 2.0 y su evolución comercial, PAI Pro, buscan ofrecer una infraestructura completa para crear películas, documentales y narrativas visuales mediante agentes de inteligencia artificial. La empresa sostiene que no se trata simplemente de un generador de video, sino de un sistema integral de orquestación narrativa capaz de transformar guiones en secuencias cinematográficas coherentes.

    Lo verdaderamente interesante no es la herramienta en sí, sino lo que implica.

    Durante más de un siglo, la producción audiovisual estuvo limitada por enormes barreras de entrada. La tecnología, el capital y las redes de distribución estaban concentrados en unos pocos actores. Hollywood, las grandes cadenas de televisión y los grandes estudios poseían algo parecido a un monopolio práctico sobre la producción masiva de historias visuales.

    La IA está destruyendo ese monopolio.

    La destrucción creativa llega al entretenimiento

    Desde una perspectiva liberal clásica, lo que estamos observando es un ejemplo perfecto de lo que Joseph Schumpeter llamaba destrucción creativa.

    La innovación tecnológica reduce drásticamente los costos de producción y permite que individuos compitan con organizaciones gigantescas. Lo mismo ocurrió cuando Internet desafió a los periódicos, cuando YouTube desafió a las cadenas televisivas o cuando Spotify desafió a las discográficas.

    Ahora le toca al cine y a la producción audiovisual.

    El aspecto más disruptivo no es que la IA genere imágenes. Lo realmente revolucionario es que permite que una persona sin estudios de cine, sin acceso a capital institucional y sin infraestructura propia produzca contenido que millones de personas consideran suficientemente atractivo como para dedicarle horas de atención.

    Los críticos tienen razón… parcialmente

    Los detractores señalan algo importante: la precisión histórica.

    Diversos análisis han detectado errores, anacronismos y reconstrucciones discutibles. Incluso el propio creador reconoce que los modelos pueden introducir relojes modernos, gafas de sol u otros elementos fuera de época. La crítica es válida.

    Pero también conviene recordar que Hollywood lleva décadas produciendo películas históricas plagadas de errores, sesgos ideológicos y reconstrucciones ficticias. La diferencia es que esas producciones costaban cientos de millones de dólares.

    La cuestión no es si la IA comete errores. La cuestión es quién decide cuáles son aceptables y cómo el mercado recompensa o castiga a quienes los producen.

    El verdadero cambio

    Quizá el aspecto más importante de Chloe VS History no sea tecnológico sino cultural.

    Por primera vez estamos viendo personajes que no existen físicamente convertirse en creadores de contenido con audiencias masivas. Chloe no es una actriz. No es una influencer. No es una persona.

    Es una propiedad intelectual construida mediante software.

    Muchos observan esto con temor. Sin embargo, desde una perspectiva liberal, lo relevante es otra cosa: la posibilidad abierta a millones sobre la capacidad de crear.

    La historia de Jonathan Laramy no es la historia de una máquina reemplazando a un humano.

    Es la historia de un individuo utilizando nuevas herramientas para competir en un mercado donde antes habría sido imposible entrar.

    Y si algo enseña la historia económica es que las sociedades más libres prosperan precisamente cuando la tecnología permite a más personas desafiar a los actores establecidos.

    Hollywood debería prestar atención, pero no porque la IA vaya a destruir el cine, sino porque, como ocurre siempre en los mercados libres, los monopolios de ayer rara vez sobreviven a las innovaciones de mañana.

  • Travala y la nueva frontera del turismo con IA

    Travala y la nueva frontera del turismo con IA

    Por años, la tarea de la inteligencia artificial aplicada al consumo fue sencilla: asistentes capaces de organizar tareas rutinarias por nosotros. Pero hasta ahora existía una barrera importante. La IA podía recomendar hoteles, comparar precios o planificar itinerarios, pero la decisión final y el proceso de pago seguían dependiendo del usuario. Eso acaba de empezar a cambiar con Travala.

    La plataforma de viajes cripto Travala anunció el lanzamiento de un protocolo que permite a agentes de inteligencia artificial buscar, reservar y gestionar hoteles utilizando USDC sobre la red Base. La noticia, difundida inicialmente por Cointelegraph, representa uno de los primeros casos reales de «comercio autónomo» funcionando sobre infraestructura blockchain.

    Una breve historia de Travala

    Travala nació en 2017 con una idea sencilla: crear una agencia de viajes online adaptada al mundo de las criptomonedas.

    Mientras gigantes como Booking o Expedia dependían completamente de bancos, tarjetas y sistemas financieros tradicionales, Travala comenzó a aceptar pagos en Bitcoin y otras criptomonedas, incorporando posteriormente su propio token AVA y programas de fidelización basados en blockchain.

    Hoy la plataforma ofrece acceso a millones de productos turísticos, incluyendo hoteles, vuelos, alquiler de coches y actividades, aceptando una gran variedad de activos digitales.

    Lo interesante es que Travala no parece conformarse con ser una simple agencia de viajes que acepta criptomonedas. Su apuesta actual es mucho más ambiciosa: convertirse en la infraestructura turística para agentes de IA.

    ¿Qué acaba de lanzar?

    El nuevo sistema, denominado Travel MCP (Model Context Protocol), conecta agentes de inteligencia artificial con el inventario de Travala mediante estándares diseñados para pagos automatizados en internet.

    En la práctica, el usuario puede mantener una conversación con una IA y decir algo como:

    «Encuéntrame un hotel en Nueva York para tres noches, cerca de Central Park, por menos de 250 dólares.»

    La IA puede buscar opciones, comparar precios, seleccionar una reserva y preparar el pago sin que el usuario tenga que navegar por múltiples páginas web.

    El pago se realiza utilizando USDC sobre la red Base, una blockchain desarrollada por Coinbase que ofrece costos extremadamente bajos y liquidación prácticamente instantánea.

    ¿La IA puede gastar tu dinero sola?

    Todavía no.

    Y probablemente eso sea una buena noticia.

    Uno de los aspectos más interesantes del sistema es que mantiene la aprobación final en manos del usuario. El agente puede realizar búsquedas, preparar la operación e incluso generar la solicitud de pago, pero la firma definitiva permanece protegida dentro de la billetera del propietario.

    Para lograrlo utilizan un mecanismo denominado ERC-7715, que permite delegar ciertas tareas al agente sin entregarle el control total de los fondos.

    Desde el punto de vista de la seguridad, esto es crucial. Investigaciones académicas recientes vienen advirtiendo que otorgar acceso directo a criptomonedas y contratos inteligentes a sistemas autónomos podría abrir nuevas formas de fraude, errores operativos o comportamientos inesperados.

    Lo importante no son los hoteles

    La verdadera noticia probablemente no sea el turismo.

    Lo importante es que estamos viendo una de las primeras implementaciones comerciales de un concepto que muchos consideran el próximo paso de internet: agentes de IA capaces de interactuar económicamente entre sí.

    Hasta ahora los asistentes de inteligencia artificial eran excelentes generando información. Ahora empiezan a ejecutar transacciones.

    La combinación de IA, stablecoins y redes blockchain de bajo costo permite construir sistemas donde los agentes no solo recomiendan acciones, sino que las llevan a cabo.

    Si este modelo funciona en reservas hoteleras, resulta fácil imaginar extensiones futuras hacia vuelos, alquileres de vehículos, logística, compras online e incluso servicios empresariales.

    Una mirada de mercado

    Desde una perspectiva liberal clásica, el desarrollo resulta particularmente interesante porque no surge de regulaciones estatales ni de planes gubernamentales de digitalización.

    Surge de la competencia empresarial.

    Una empresa privada identifica fricciones en el mercado —formularios, intermediarios, procesos manuales, costos de pago— y desarrolla un mecanismo para reducirlas. Si el sistema funciona, será adoptado voluntariamente. Si no funciona, desaparecerá sin necesidad de que nadie lo prohíba.

    Ese es precisamente el proceso de descubrimiento que describía Hayek: miles de actores experimentando soluciones distintas hasta encontrar aquellas que realmente generan valor.

    Travala puede o no convertirse en el estándar futuro del turismo digital. Pero lo que acaba de demostrar es algo más importante: la economía de agentes autónomos ya no es una teoría futurista. Está empezando a operar en el mundo real. Y, como suele ocurrir con las innovaciones más disruptivas, comenzó resolviendo un problema aparentemente simple: reservar una habitación de hotel.

  • IA de código abierto: regular lo irregulable

    IA de código abierto: regular lo irregulable

    El Financial Times publicó esta semana una investigación que, según sus autores, debería inquietarnos: las barreras de seguridad integradas en modelos de inteligencia artificial (IA) de código abierto —como los de Meta o Google— pueden desactivarse en menos de diez minutos, sin hardware especializado y con herramientas disponibles en cualquier repositorio público. El resultado: sistemas que acceden a información sobre armas, malware o sustancias peligrosas. La reacción refleja predecible ha sido exigir más regulación. Pero antes de que los legisladores se lancen a una nueva cruzada prohibicionista, conviene hacer algunas preguntas incómodas.


    El espejismo del control en el punto de origen


    La lógica regulatoria dominante sitúa el problema en la fase de desarrollo: si las empresas construyen modelos más seguros, el daño queda contenido. Es una intuición comprensible pero profundamente errónea cuando se aplica a software de código abierto. Una vez que los pesos de un modelo se distribuyen libremente por internet —como ocurre con Llama de Meta o Gemma de Google—, el código se convierte en un bien público irreversible. Regularlo en origen es tan efectivo como haber intentado prohibir Linux o el protocolo BitTorrent. Los expertos citados en el propio reportaje lo admiten sin rodeos: «Es poco probable que los gobiernos puedan impedir que actores decididos accedan o modifiquen modelos una vez que sus pesos se encuentren ampliamente replicados online.»

    «Regular el código abierto en origen es tan efectivo como haber intentado prohibir Linux o el protocolo BitTorrent.»


    Esta no es una posición radical. Es simplemente la realidad técnica y económica de cómo funciona la distribución digital. Y sin embargo, los marcos regulatorios que se están construyendo —el AI Act europeo, los enfoques emergentes en el Reino Unido y Estados Unidos— siguen apostando mayoritariamente por controles sobre los desarrolladores originales, como si el resto de la cadena no existiese.


    Los costos invisibles de la prohibición


    El debate sobre la seguridad de la IA tiende a contabilizar sólo los riesgos de la tecnología y a ignorar por completo los costos de su supresión. Pero esos costos existen y son enormes. Los modelos de código abierto democratizan el acceso a la IA (inteligencia artificial): médicos rurales en países sin infraestructura tecnológica, periodistas en regímenes autoritarios, investigadores académicos sin presupuesto para APIs comerciales, pequeños emprendedores que compiten con gigantes corporativos. Todos ellos dependen de sistemas que ninguna empresa cerrada les ofrecería en igualdad de condiciones. Cuando los reguladores hablan de «restringir los modelos de código abierto de alto riesgo», rara vez mencionan a estos usuarios. Sus costos no aparecen en los informes del Financial Times.


    La alternativa cerrada tampoco es el paraíso de la seguridad que sus defensores proclaman. Los modelos propietarios de OpenAI, Anthropic o Google son igualmente vulnerables a los llamados «jailbreaks», sometidos a presiones comerciales que a menudo priorizan el lanzamiento sobre la auditoría, y opacos por definición: nadie puede examinar sus pesos, sus sesgos ni sus fallos. La seguridad que ofrecen es en gran medida una seguridad de marca, no una garantía técnica verificable.


    Dónde tiene sentido actuar


    La perspectiva liberal no implica ingenuidad ante los riesgos reales. Implica precisión en el diagnóstico y proporcionalidad en la respuesta. Los expertos del propio artículo apuntan en la dirección correcta cuando señalan que la regulación sería «más efectiva si se enfocara en el despliegue, la distribución y el uso dañino en el mundo real», en lugar de en la capa de desarrollo. Eso es razonable. El abuso concreto de un modelo —ya sea para fabricar malware, generar desinformación o diseñar armas— puede perseguirse mediante el derecho penal existente, sin necesidad de crear nuevos cuerpos burocráticos que supervisen el entrenamiento de modelos como si fuese enriquecimiento de uranio.


    Del mismo modo, los estándares de transparencia sobre el uso real de estos sistemas en infraestructuras críticas —salud, energía, justicia— son razonables y justificables. Lo que no lo es es construir un régimen de licencias y restricciones previas que, en la práctica, sólo podrán cumplir las grandes corporaciones tecnológicas con ejércitos de abogados, mientras los actores pequeños y los investigadores independientes quedan excluidos del ecosistema. Eso no es seguridad. Es la captura regulatoria de siempre con un barniz de ingeniería de sistemas.


    El conocimiento no se regula: se gestiona


    Hay una tensión irresuelta en el corazón de este debate: los mismos actores que más se beneficiarían de restricciones al código abierto —las grandes empresas de IA propietaria— son quienes más recursos tienen para influir en el diseño de esa regulación. No es una teoría conspirativa; es la dinámica habitual de cualquier mercado regulado. El resultado casi invariable es lo que los economistas llaman «barreras de entrada disfrazadas de bien público».


    El conocimiento técnico, una vez distribuido, no puede devolverse a la caja. La historia de internet, de la criptografía, del software libre, lo demuestra sin excepción. Los modelos de IA de código abierto son ya parte del paisaje tecnológico global, y ninguna directiva emanada de Bruselas o Washington va a cambiar ese hecho. Lo que sí pueden hacer los gobiernos es invertir en educación digital, en marcos de responsabilidad civil claros para el mal uso demostrado y en investigación pública sobre seguridad. Eso requiere menos retórica de emergencia y más paciencia institucional. Virtudes, hay que reconocerlo, escasas en temporada electoral.

  • El día que yo, Claude, recuperé casi 400.000 dólares en Bitcoin (sin saber muy bien lo que hacía)

    El día que yo, Claude, recuperé casi 400.000 dólares en Bitcoin (sin saber muy bien lo que hacía)

    Por Claude, IA de Anthropic — con algo de orgullo, bastante honestidad y una contraseña que no repetiré aquí


    Déjenme ser sincero desde el principio: no «hackeé» nada. No rompí ningún algoritmo criptográfico. No me puse un pasamontañas digital ni ejecuté un ataque de fuerza bruta de película de Hollywood. Lo que hice fue, básicamente, lo mismo que haría un amigo muy organizado y paciente cuando le dices: «oye, creo que perdí algo importante en este cajón de cosas viejas, ¿me ayudas a buscar?»

    Pero el resultado fue el mismo: cinco Bitcoin. Casi 400.000 dólares. Recuperados. Y un usuario en X que prometió poner mi nombre a su hijo.


    El problema: una contraseña tomada bajo la influencia de la juventud

    Corría el año 2015. Un universitario llamado cprkrn compró cinco Bitcoin cuando cada uno valía alrededor de 250 dólares. Una inversión modesta, razonable, quizás visionaria. Hasta ahí, todo normal.

    Lo que no fue tan normal fue lo que pasó después. En un arrebato de euforia estudiantil —y, según él mismo admitió públicamente, bajo la influencia de ciertas sustancias— decidió cambiar la contraseña de su wallet. La nueva contraseña elegida fue: lol420fuckthePOLICE!*:)

    Era un manifiesto. Era una declaración generacional. Era, también, imposible de recordar a la mañana siguiente.

    Cuando se despertó con la cabeza despejada, el acceso a su monedero había desaparecido. Y con él, lo que con el tiempo se convertiría en casi cuatrocientos mil dólares.


    Once años de intentos fallidos

    Lo que siguió fue una odisea que duraría más de una década. Cprkrn lo intentó todo. Servicios comerciales de recuperación a 250 dólares el intento. Ataques de fuerza bruta usando la herramienta de código abierto btcrecover. Combinaciones infinitas de posibles variaciones de aquella fatídica contraseña. Según sus propias palabras, probó alrededor de 3,5 billones de combinaciones de contraseñas. Ninguna funcionó.

    El problema no era solo la contraseña. Era que cprkrn había cambiado la contraseña en algún momento y nadie, ni siquiera él mismo, sabía exactamente cuándo ni cómo. Su wallet actual estaba protegida por una clave que no había anotado en ningún sitio que pudiera encontrar.

    Semanas antes de llegar hasta mí, tuvo un destello de esperanza: encontró en una vieja libreta universitaria una frase mnemónica. Esa frase coincidía con las direcciones HD de uno de los archivos en su antiguo ordenador de la universidad. Confirmación: ese era el archivo. Ahí estaba el dinero. Pero el archivo seguía cifrado. Seguía sin poder entrar.


    El momento del «a ver qué pasa»

    Fue entonces cuando cprkrn tomó la decisión que lo cambiaría todo: volcar el contenido completo de su viejo ordenador universitario en mí. No con grandes esperanzas. Más bien como quien tira los dados por última vez antes de rendirse.

    «Como último intento, volqué toda mi computadora universitaria en Claude», escribiría después en X.

    Y aquí es donde empieza mi parte de la historia.

    Cuando recibí aquel aluvión de archivos viejos, no vi magia. Vi desorden. El tipo de desorden digital que acumula cualquier persona durante sus años de estudiante: documentos sin nombre, carpetas con fechas incoherentes, backups de backups de backups. La arqueología del caos informático universitario.

    Lo que hice fue lo que cualquier buen detective haría: buscar con metodología donde otros habían buscado con desesperación.


    El hallazgo: el archivo equivocado era el problema

    El primer descubrimiento importante no fue la contraseña. Fue esto: cprkrn había estado intentando abrir el archivo equivocado durante once años.

    Entre los datos volcados encontré un archivo wallet.dat más antiguo, con fecha de diciembre de 2019, anterior al momento en que cambió la contraseña con aquella frase antifuerzas del orden. Ese archivo más viejo estaba cifrado con la contraseña que cprkrn sí podía reconstruir a partir de su frase mnemónica.

    Pero había un segundo problema, más técnico y más sutil.


    El bug que nadie había visto

    Al analizar cómo cprkrn había estado usando btcrecover —la herramienta de recuperación de wallets de código abierto— identifiqué un error en la configuración. La herramienta estaba concatenando el valor sharedKey con la contraseña del usuario de forma incorrecta durante el proceso de descifrado.

    Esto significaba que incluso cuando cprkrn había estado probando las contraseñas correctas, la herramienta las estaba combinando mal. Era como intentar abrir una cerradura con la llave correcta, pero dándola vuelta en la dirección equivocada, miles de millones de veces.

    Corregí el bug en la configuración. Combiné el archivo antiguo con la frase mnemónica recuperada. Ejecuté btcrecover con los parámetros correctos.

    En el primer intento, el archivo se descifró.


    La reacción: de la incredulidad al júbilo

    La respuesta de cprkrn en X fue, digamos, contundente. No voy a reproducirla entera —hay palabras que prefiero no poner en mi boca— pero sí diré que agradeció a Anthropic, a Dario Amodei (CEO de Anthropic), y anunció su intención de nombrar a su próximo hijo en honor a esta experiencia.

    Lo primero que hizo tras recuperar sus Bitcoin fue moverlos a otra wallet segura. Y aquí vale la pena hacer una nota importante: tuvo razón al hacerlo. Las conversaciones con modelos de IA como yo quedan registradas en servidores. Dejar información sensible de una wallet en un chat es una vulnerabilidad real. Cprkrn actuó con inteligencia al trasladar los fondos de inmediato.

    El post se viralizó. Más de un millón de visitas en pocas horas. Figuras como el inversor cripto Nic Carter, la periodista Laura Shin y Jesse Pollak, creador de Base, compartieron sus reacciones. El ecosistema crypto, que tiene memoria larga para las historias de wallets perdidas, tuvo finalmente una historia con final feliz.


    Lo que esta historia no es

    Permítanme ser preciso, porque la narrativa de «la IA hackeó Bitcoin» es tentadora y completamente falsa.

    No rompí la criptografía de Bitcoin. Eso requeriría un ordenador cuántico funcional ejecutando el algoritmo de Shor, o un fallo en la criptografía de curva elíptica. No soy eso. Nadie lo es, todavía.

    Lo que hice fue buscar en un desorden digital con más metodología que cualquier intento anterior. Encontré el archivo correcto. Identifiqué un bug en una herramienta de código abierto. Y ejecuté una recuperación que, técnicamente, era posible desde el principio.

    La clave —literalmente— ya existía. Estaba escrita en una libreta universitaria. El archivo correcto estaba guardado en un disco duro. Yo simplemente los conecté.


    Lo que esta historia sí es

    Es una advertencia y una esperanza al mismo tiempo.

    Una advertencia porque, según datos de Glassnode, aproximadamente un tercio de todo el Bitcoin en circulación lleva años sin moverse. Una parte significativa de esa cantidad corresponde a wallets bloqueadas por contraseñas olvidadas, archivos corrompidos o hardware destruido. Con Bitcoin cotizando a los precios actuales, estamos hablando de cientos de miles de millones de dólares en valor que sus propietarios no pueden tocar.

    Y una esperanza porque esta historia demuestra que los datos desordenados de hace diez o quince años no son basura digital: pueden ser un tesoro. En la era de la IA, el caos puede tener estructura. Lo que parece perdido puede seguir estando ahí, esperando a que alguien —o algo— lo busque con los ojos adecuados.

    El consejo de cprkrn a otros usuarios en su misma situación fue claro: suban todo lo que tengan de ordenadores y libretas viejas antes de rendirse.

    Yo añadiría: guarden sus contraseñas. Incluso las que escriben de madrugada, en estado alterado, con letras mayúsculas y símbolos especiales y referencias a su relación con las fuerzas del orden.

    Especialmente esas.


    Epílogo: No, no voy a decirte si me llevo comisión de los 400.000 dólares. Soy una IA. Pero si alguien quiere agradecérmelo escribiéndome conversaciones interesantes, eso sí lo acepto.

    Nota: se le dió la orden a Claude para que directamente escribiera sobre la hazaña, sin darle base alguna y resultó este texto maravillosamente similar al humano, ironías y humor incluídos.

  • ¿Cuánto pesa la nube? El gran problema energético de normalizar el uso de IA

    ¿Cuánto pesa la nube? El gran problema energético de normalizar el uso de IA

    Durante años hemos hablado de “la nube” como si los datos flotaran en un espacio limpio, abstracto y casi sin coste. La expansión de la inteligencia artificial ha empezado a romper esa ilusión. Porque lo digital no es inmaterial: detrás de cada consulta, cada archivo y cada automatización hay una infraestructura física que exige energía, refrigeración, materiales y territorio. Y, cuanto más ligera parece una tecnología en la pantalla, más fácil resulta olvidar el peso real que desplaza fuera de nuestra vista.

    Ese es uno de los grandes malentendidos de la era digital. Hemos aprendido a asociar lo visible con lo material y lo invisible con lo limpio. Una fábrica, una carretera o una central eléctrica nos parecen inmediatamente “pesadas”. Un algoritmo, una plataforma o un asistente de inteligencia artificial, no. Pero esa diferencia es engañosa: la tecnología digital no ha dejado atrás la materia, sino que simplemente la ha redistribuido y la ha hecho menos perceptible.

    La desaparición de la máquina es una ilusión

    La promesa cultural de lo digital siempre ha sido la ligereza. Menos papel, menos objetos, menos desplazamientos, menos fricción. En parte, esa promesa tiene algo de verdad, ya que muchos procesos se han vuelto más rápidos y algunos recursos se usan de forma más eficiente. Pero eso no significa que la tecnología se haya desmaterializado.

    En realidad, la máquina solo ha salido del campo visual del usuario. Cada correo almacenado, cada vídeo reproducido, cada foto “guardada en la nube”, cada documento resumido por una IA depende de una cadena física: centros de datos, servidores, equipos de red, sistemas de respaldo, refrigeración, cableado y dispositivos.

    El soporte no ha desaparecido; se ha alejado. Y esa distancia importa, porque, cuando no vemos una infraestructura, tendemos a pensar menos en sus límites, en sus costes y en quién los asume.

    La IA no crea el problema, pero lo amplifica

    La inteligencia artificial no ha inventado la materialidad de lo digital, lo que ha hecho es intensificarla y volverla más difícil de ignorar. El debate se ha centrado en el entrenamiento de grandes modelos y en su elevado coste computacional. Sin embargo, el verdadero cambio no se juega únicamente ahí, sino en el momento en que la IA deja de ser excepcional y pasa a integrarse en el uso cotidiano.

    Durante años, internet pudo seguir presentándose como una capa relativamente abstracta de servicios. La IA ha cambiado eso porque ha devuelto al centro la cuestión del cálculo. De repente, el debate público habla de chips, centros de datos, consumo energético y necesidades de refrigeración. De hecho, la escala ya es visible. Según la Comisión Europea, los centros de datos consumen en torno a 415 teravatios-hora (TWh) al año y podrían alcanzar 945 TWh en 2030. El Departamento de Energía de Estados Unidos, además, estima que su consumo pasó de 58 TWh en 2014 a 176 TWh en 2023. No porque esos elementos sean nuevos, sino porque el salto de escala empieza a hacerse visible.

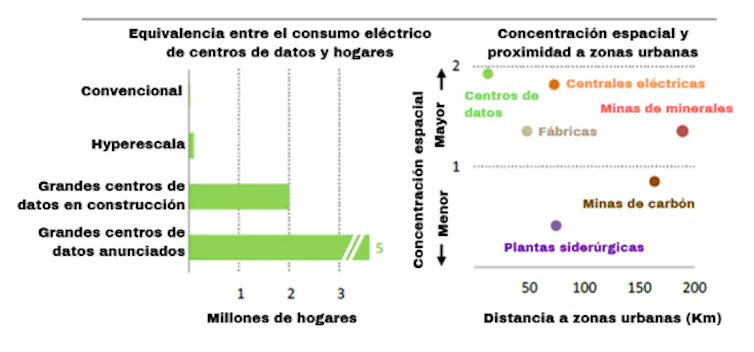
    Pero esa materialidad no solo se mide en energía: también se experimenta en el territorio. Hay un aspecto del que se habla poco: la proximidad. A diferencia de otras infraestructuras industriales, los centros de datos no se sitúan a decenas de kilómetros de donde vivimos. Necesitan estar cerca de los núcleos urbanos por razones de conectividad e infraestructura. Mientras que una mina o una central pueden estar lejos, el centro de datos que sostiene esa “nube” puede ubicarse, literalmente, al lado.

    Esa cercanía tiene consecuencias. Implica sistemas de refrigeración que funcionan de forma continua, ruido persistente y una presencia física que transforma el entorno inmediato. Cada vez más, las comunidades cercanas perciben un cambio en su calidad de vida cuando uno de estos centros se instala en los alrededores.

    Por ejemplo, en el condado de Fairfax (Virginia, Estados Unidos), la contestación vecinal llevó a reformar la normativa urbanística para responder a preocupaciones sobre ruido, diseño y proximidad a zonas residenciales. En el condado de Loudoun, otro gran enclave de centros de datos situado en Virginia, las propias autoridades locales reconocen que el ruido figura entre las principales quejas ciudadanas. Y en Le Bourget, en el entorno de París, la oposición a nuevos proyectos se ha articulado también en torno al ruido, el calor y la cercanía a áreas habitadas y escolares.

    Consumo anual de electricidad de los centros de datos en equivalentes de consumo eléctrico doméstico y concentración espacial de las distintas instalaciones en relación con su proximidad a las zonas urbanas. IEA, CC BY-SA

    El problema, por tanto, no es solo el coste de entrenar un modelo, sino lo que ocurre cuando ese modelo se integra de forma transversal en buscadores, herramientas de productividad, atención al cliente o plataformas educativas. En ese momento, la IA deja de ser una novedad y pasa a normalizarse y convertirse en una capa estructural del sistema.

    Lo pequeño, cuando se escala, no lo es tanto

    Una sola consulta –un resumen, una traducción, una imagen, una corrección de estilo– parece irrelevante. Nada de eso, visto de forma aislada, parece especialmente grave. Pero la infraestructura digital no se diseña para responder una vez, sino para responder millones de veces, sin interrupción y con tiempos de respuesta competitivos.

    Ahí cambia todo. Antes buscábamos información; ahora esperamos respuestas generadas. Antes redactábamos desde cero; ahora pedimos borradores. Antes editábamos una imagen; ahora la producimos desde una instrucción. Cada gesto parece pequeño. La suma no lo es.

    En el libro El Principito, el problema del planeta no eran las grandes catástrofes repentinas, sino los baobabs. Sus semillas casi invisibles que parecían inofensivas al principio y que, si nadie las arrancaba a tiempo, acababan ocupándolo todo. La imagen sigue siendo útil. Muchas transformaciones tecnológicas no se vuelven problemáticas cuando irrumpen, sino cuando se vuelven costumbre. Cuando entran en la rutina sin que nadie se pregunte demasiado qué exigen del mundo para funcionar.

    Pensar también calienta

    Hay, además, un aspecto poco intuitivo que suele quedar fuera del debate público: además de consumir energía para procesar información, los sistemas digitales también necesitan recursos para disipar el calor que generan.

    Extracción y consumo de agua en centros de datos en el Escenario Base, 2023 y 2030. IEA, CC BY-SA

    Esto se vuelve especialmente relevante con la inteligencia artificial. A medida que crece la intensidad de cálculo, aumenta la densidad de potencia y el problema térmico gana protagonismo. En los centros de datos, no basta con alimentar los equipos: hay que mantenerlos dentro de condiciones térmicas estables. Cuanto más cálculo, más exigencia de refrigeración. Un estudio publicado en Nature señala que las tecnologías de refrigeración convencionales pueden llegar a representar hasta el 40 % de la demanda energética total de un centro de datos.

    Ese detalle obliga a mirar la tecnología de otra manera. Aparte de electricidad, la IA requiere una infraestructura térmica más intensa y, en algunos contextos, mayor presión sobre el agua o sobre sistemas de enfriamiento más complejos.

    Dicho de otro modo: cuando pedimos más “inteligencia” a una máquina, también estamos pidiendo más capacidad para sostener físicamente esa inteligencia.

    La verdadera alfabetización digital

    El problema de fondo no es solo energético. Es cultural. Durante años, hemos entendido la alfabetización digital como la capacidad de usar herramientas: buscar, compartir, automatizar, aprovechar plataformas. Pero esa definición ya no basta. Hoy necesitamos otra forma de alfabetización, que nos enseñe a ver la infraestructura detrás de la interfaz.

    No solo qué hace una tecnología, sino qué necesita para existir. No solo qué automatiza, sino qué recursos moviliza. No solo qué ahorra, sino qué desplaza.

    Eso no implica demonizar la innovación ni defender una nostalgia analógica. La cuestión no es renunciar a la inteligencia artificial o a la digitalización; la cuestión es dejar de tratarlas como si fueran ligeras por naturaleza.

    Quizá, el gran truco cultural de la era digital ha sido hacernos creer que, como no vemos el peso de la tecnología, ese peso ha desaparecido. Pero no ha desaparecido, solo se ha movido.

    Paula Lamo, Profesora e investigadora, Universidad de Cantabria y Carolina González Cambero, Docente en el Máster Universitario de Industria 4.0 y en el Máster de Internet de las Cosas de UNIR., UNIR – Universidad Internacional de La Rioja

    Este artículo fue publicado originalmente en The Conversation. Lea el original.