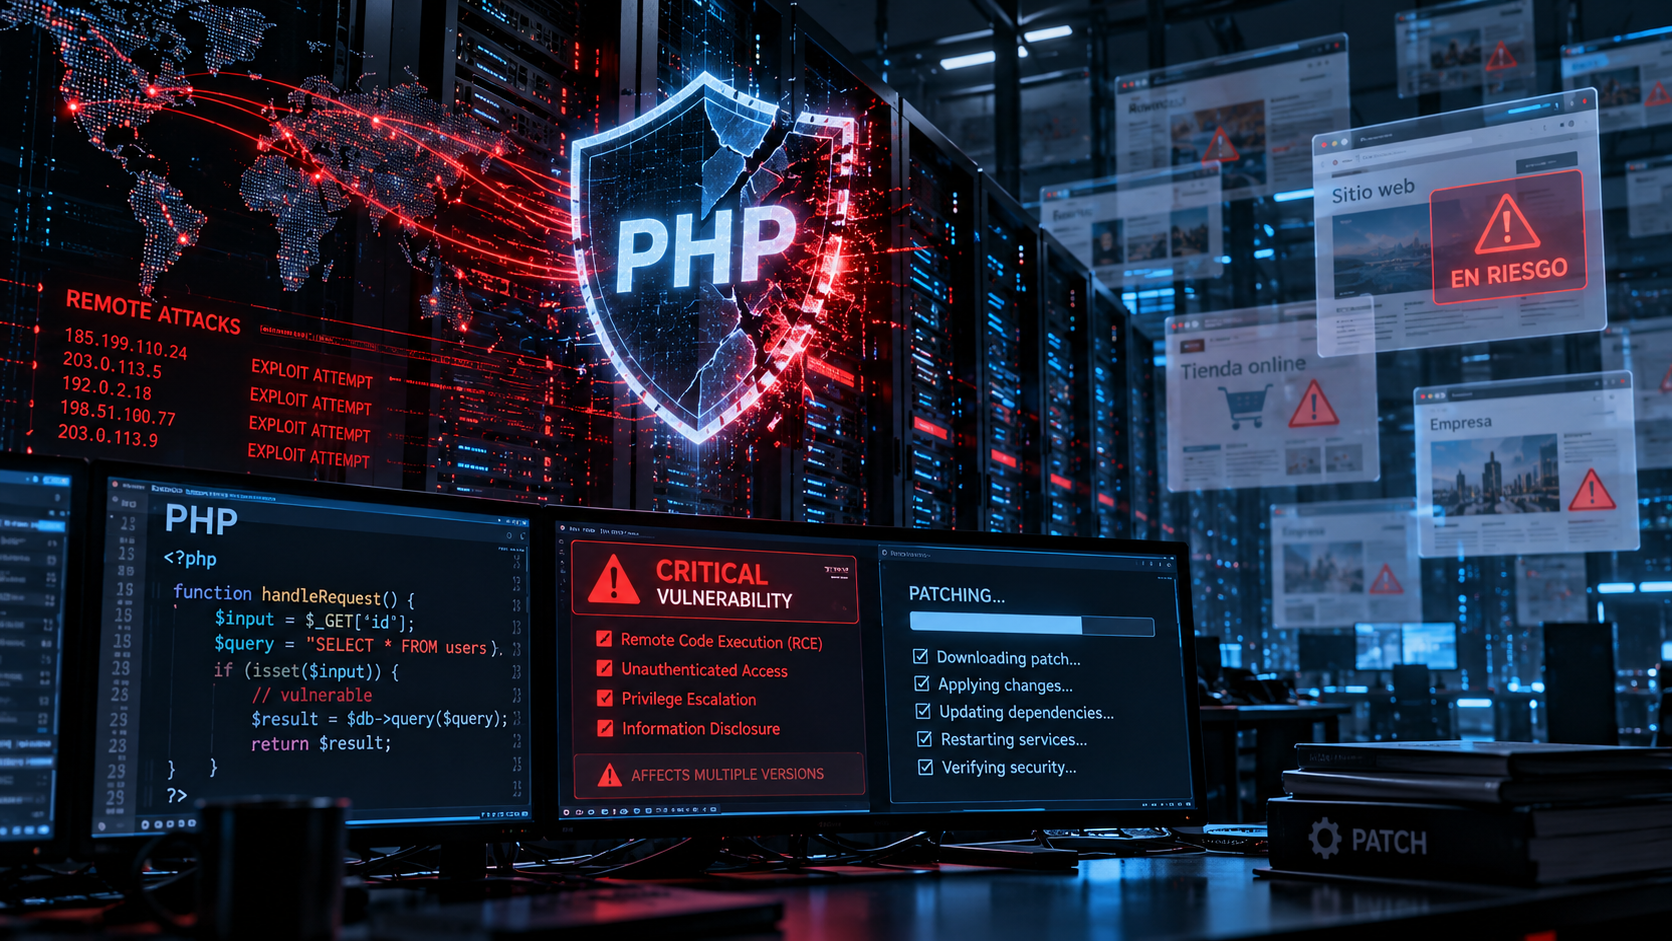
Durante años usamos Internet con una confianza bastante curiosa: escribimos una dirección, abrimos una página y asumimos que detrás todo funcionará. Pero hoy, 21 de octubre de 2026, dos vulnerabilidades críticas en PHP —uno de los lenguajes que sostienen buena parte de la web— obligaron a miles de administradores a actualizar de urgencia sus servidores y llevaron incluso a que varios sitios gubernamentales europeos fueran desconectados temporalmente. PHP publicó cuatro versiones de seguridad para corregir dos fallas capaces de permitir ejecución remota de código sin autenticación, es decir, que un atacante pueda llegar a ejecutar instrucciones en un servidor sin tener una cuenta ni credenciales.
No es un detalle técnico menor.
En determinadas configuraciones, el ataque puede producirse incluso antes de que el código de la propia página web llegue a ejecutarse. PHP ha recomendado actualizar inmediatamente a las versiones corregidas y reconoce que, si no puede hacerse, las medidas temporales sólo reducen el riesgo: no sustituyen al parche.
Y aquí empieza una discusión que va mucho más allá de PHP.
¿De quién es la culpa?
Es tentador buscar inmediatamente un culpable.
¿PHP?
¿El proveedor de hosting?
¿El dueño de la página?
¿El hacker?
La respuesta incómoda es que responsabilidad y causalidad no son lo mismo.
La vulnerabilidad estaba en PHP. La propia PHP Foundation reconoció además que señales tempranas de uno de los problemas habían sido detectadas ya en 2024 y que la demora en resolverlo fue un “fallo estructural”. En aquel momento se había teorizado sobre el problema, pero no se encontró una vía concreta de explotación y otras incidencias consideradas más claras recibieron prioridad.
Eso merece crítica.
Un proyecto que sostiene una parte significativa de Internet tiene una enorme responsabilidad cuando recibe información sobre posibles fallas de seguridad.
Pero tampoco existe software perfecto.
Y aquí aparece algo que a veces olvidamos: una vulnerabilidad no es necesariamente producto de negligencia. Los sistemas complejos acumulan interacciones que ningún programador puede anticipar completamente.
La responsabilidad real aparece en qué se hace cuando el riesgo se conoce.
Ocultarlo es irresponsabilidad.
Negarse a corregirlo es irresponsabilidad.
No advertir a los usuarios es irresponsabilidad.
Reconocerlo, publicar el parche y explicar con claridad el alcance del problema es precisamente lo contrario.
Y el propietario de una web no controla necesariamente su servidor
Ésta es otra distinción importante.
Quien administra un blog o una página en WordPress puede actualizar sus plugins, sus contraseñas y su contenido.
Pero en un alojamiento gestionado normalmente no controla la versión de PHP instalada en el servidor ni muchas de las configuraciones de seguridad que están por debajo de su aplicación.
Ahí entra el proveedor de hosting.
Su obligación no debería consistir en garantizar algo imposible —“nunca habrá una vulnerabilidad”—, sino en mantener sistemas actualizados, reaccionar rápidamente, comunicar con transparencia y reducir el impacto para sus clientes.
En otras palabras, cada parte debe responder por aquello que realmente controla.
Ése es un principio bastante liberal de responsabilidad.
No podemos responsabilizar al usuario por una vulnerabilidad en un componente que no administra.
Pero tampoco podemos exigir a un proveedor que garantice riesgo cero.
Podemos exigirle algo mucho más razonable: diligencia.
Tampoco todos los hackers son iguales
Hay otra simplificación que conviene evitar.
“Hacker” se utiliza habitualmente como sinónimo de delincuente.
Quien descubre una vulnerabilidad y la comunica responsablemente puede estar haciendo exactamente lo contrario de atacar el sistema: está mostrando dónde puede romperse antes de que lo haga alguien con malas intenciones.
Los atacantes intentarán ahora estudiar los parches, reconstruir el fallo y buscar servidores que todavía no hayan actualizado. Los especialistas advertían precisamente que esa carrera puede comenzar muy rápidamente una vez publicada una corrección.
Es una competencia extraña: investigador encuentra → desarrollador corrige → administrador actualiza → atacante intenta llegar antes.
La seguridad informática nunca termina.
No existe una muralla definitiva.
Existe adaptación.
Aquí aparece una lección muy hayekiana
Los sistemas digitales modernos son demasiado complejos para que una autoridad central conozca todos sus riesgos de antemano.
PHP es desarrollado por una comunidad.
Los investigadores externos encuentran errores.
Los proveedores de hosting implementan soluciones.
Empresas de seguridad crean mitigaciones.
Usuarios reportan comportamientos extraños.
Todos poseen fragmentos distintos de información.
Ése es precisamente el tipo de problema que Friedrich Hayek describía al hablar del conocimiento disperso.
No necesitamos imaginar un regulador omnisciente que certifique una vez y para siempre que un software es seguro.
No existe.
Lo que necesitamos es un ecosistema donde los errores puedan ser descubiertos rápidamente, comunicados y corregidos.
Competencia entre proveedores.
Auditorías.
Investigadores independientes.
Código abierto.
Responsabilidad contractual.
Reputación.
Y, sobre todo, incentivos para reconocer los errores en lugar de esconderlos.
El verdadero problema no son los hackers
Los hackers maliciosos existen y cometen delitos.
Si alguien entra en un servidor ajeno, roba información o destruye propiedad, la cuestión liberal es bastante sencilla: ha violado derechos de propiedad y debe responder por ello.
Pero pretender eliminar el riesgo prohibiendo herramientas, restringiendo investigación o concentrando la seguridad bajo una única autoridad probablemente produciría el efecto contrario.
La seguridad mejora cuando muchos ojos pueden mirar.
Cuando alguien puede cuestionar.
Cuando un investigador puede decir: “esto está mal” sin necesitar permiso de quien construyó el sistema.
Eso también es una forma de descentralización.
La confianza correcta no consiste en creer que nada fallará
Este episodio deja una enseñanza mucho más profunda.
Vivimos en sistemas que no comprendemos completamente.
Nuestra página depende de WordPress.
WordPress depende de PHP.
PHP depende del sistema operativo.
El servidor depende del proveedor.
El proveedor depende de redes, DNS, certificados, centros de datos y decenas de componentes adicionales.
La idea de seguridad absoluta es una ilusión.
Por eso la confianza racional no debería ser: “esto nunca va a fallar”. Debería ser: “cuando falle, sabremos quién responde, podremos verificar qué ocurrió y tendremos alternativas para corregirlo”.
Eso es mucho más compatible con una sociedad libre.
La vulnerabilidad de PHP no demuestra que Internet necesite más control central.
Demuestra exactamente lo contrario: los sistemas complejos necesitan responsabilidad distribuida, transparencia, competencia y capacidad de corregir errores rápidamente.
No podemos eliminar la vulnerabilidad humana ni tecnológica.
Podemos, en cambio, construir instituciones donde equivocarse no implique ocultar el error y donde cada actor responda por aquello que realmente estaba bajo su control.
Y ésa, quizá, sea la diferencia entre una sociedad segura y una sociedad simplemente controlada.
Deja una respuesta